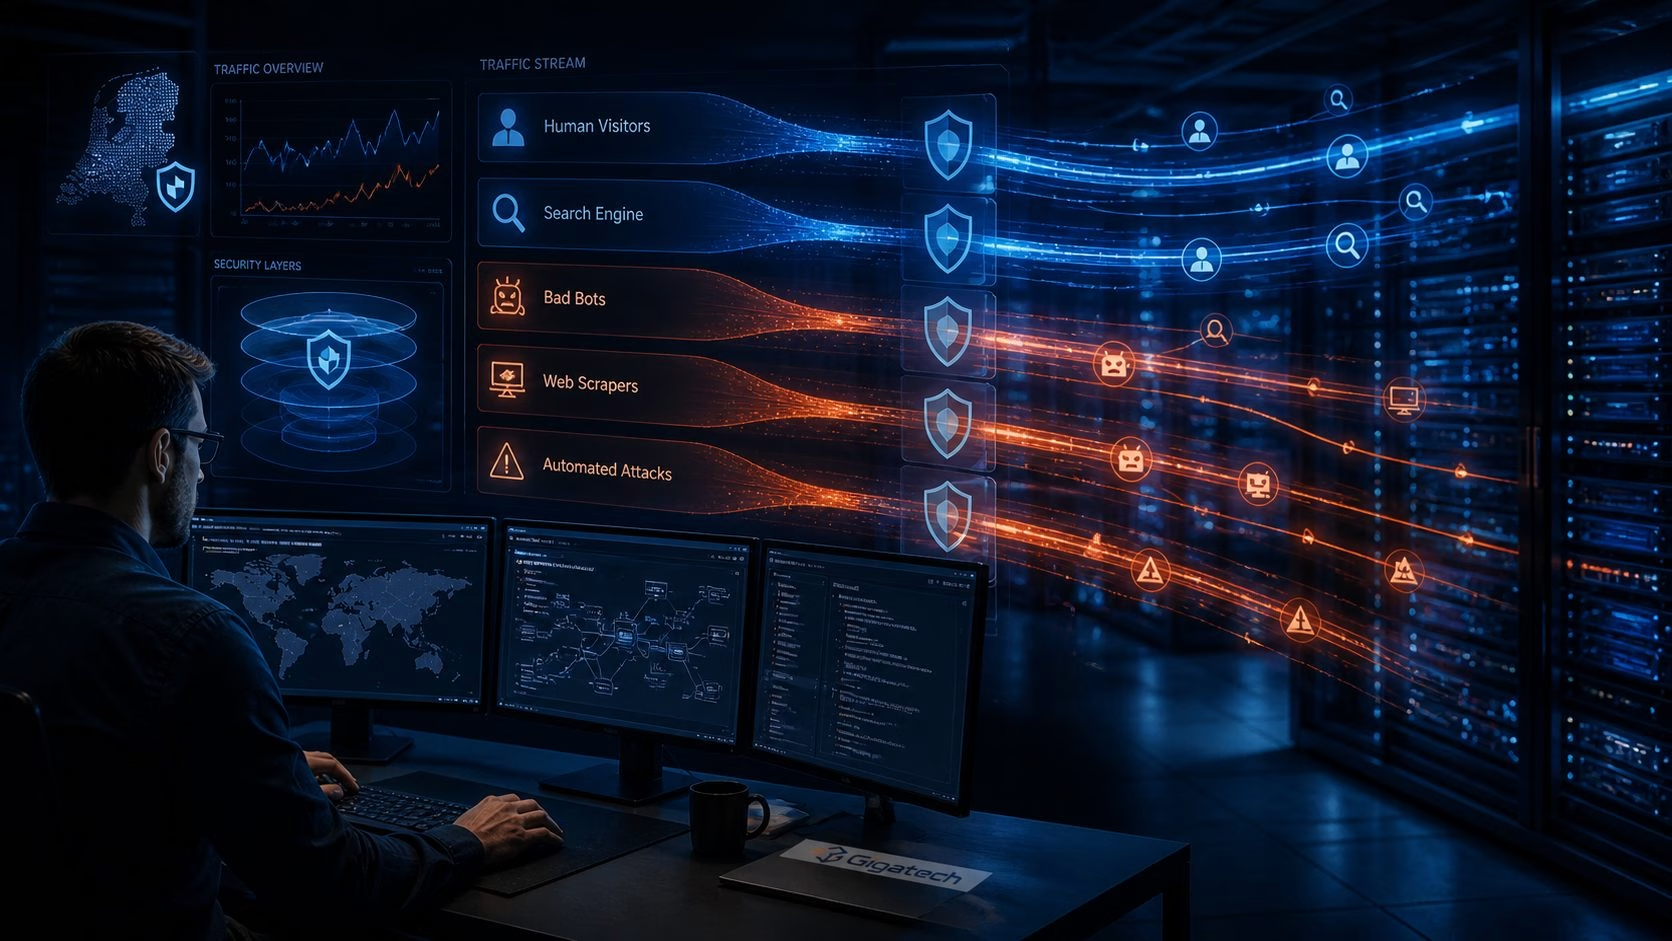
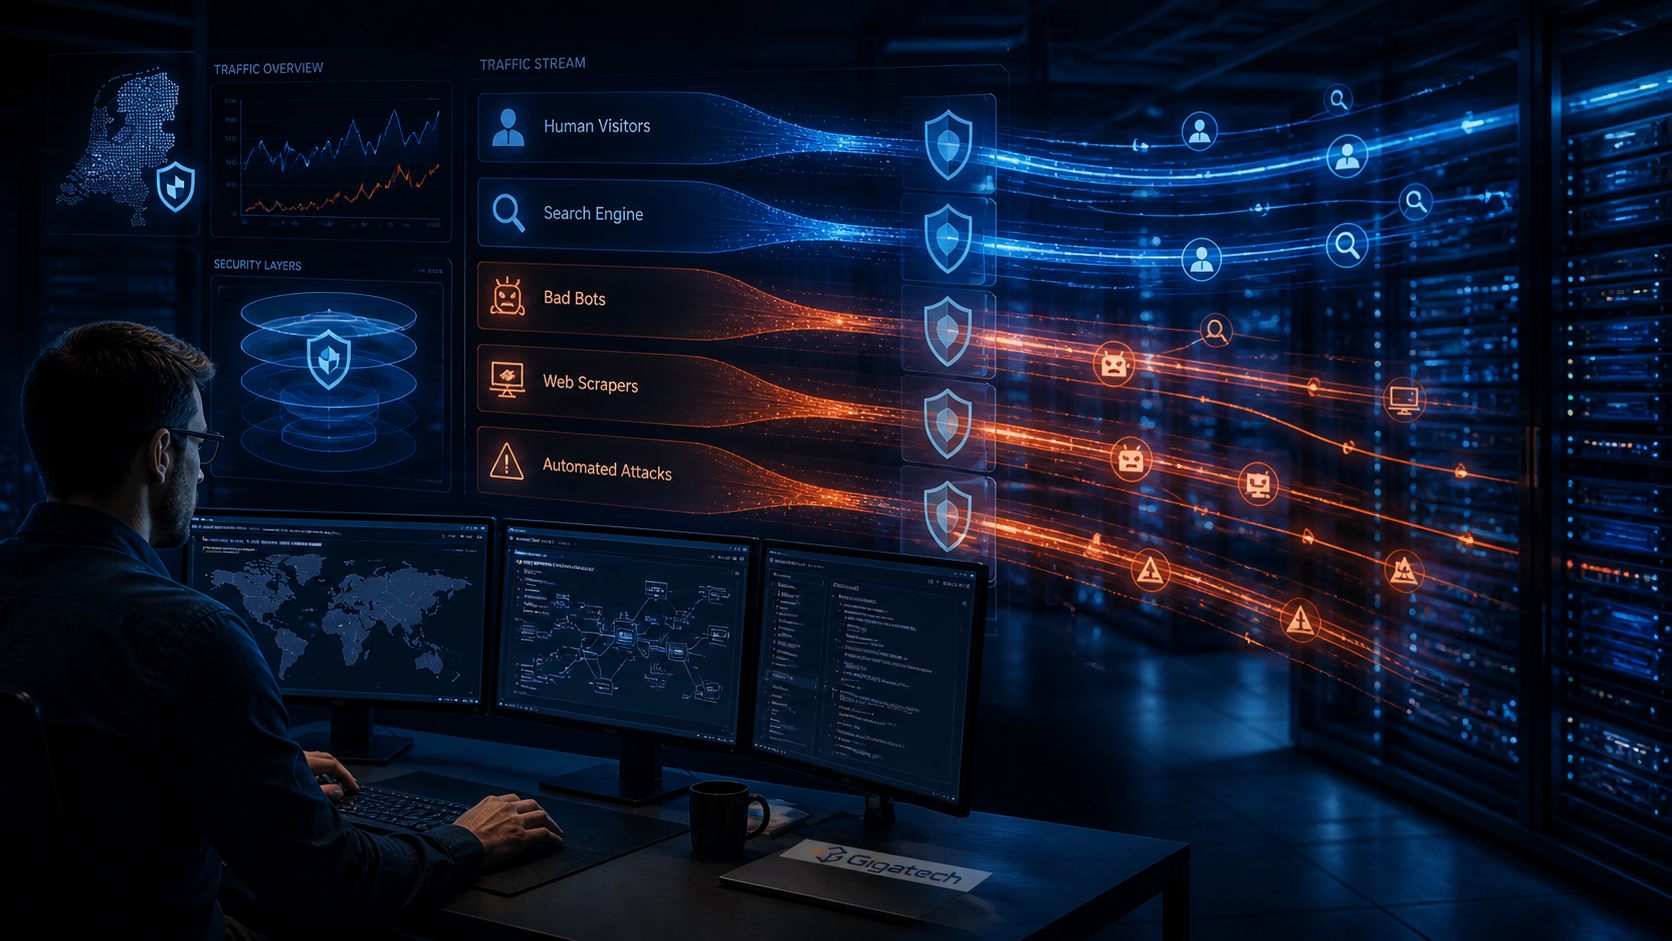
Niet iedere robot is slecht. Zoekmachines, uptimecontroles en toegestane integraties bezoeken websites automatisch met een duidelijk doel. Andere bots proberen wachtwoorden, kopiëren prijzen, vullen formulieren, verzamelen e-mailadressen of vragen duizenden nutteloze URL’s op. Het probleem is daarom niet “bots blokkeren”, maar verkeer herkennen en proportioneel behandelen.
Goede, twijfelachtige en schadelijke automatisering
Een betrouwbare zoekmachine identificeert zich, volgt redelijke crawlpatronen en kan technisch worden geverifieerd. Een scraper kan openbare content ophalen zonder direct een aanval uit te voeren, maar wel capaciteit en intellectueel eigendom belasten. Schadelijke bots zoeken logins, kwetsbare plugins, open formulieren en betaalprocessen. Alleen de user-agent vertrouwen is onvoldoende: die tekst is eenvoudig te vervalsen.
Wat merkt een website-eigenaar?
- Veel verzoeken naar niet-bestaande pagina’s, wp-login.php of xmlrpc.php.
- Plotselinge pieken in CPU, PHP-processen, databasequeries of bandbreedte.
- Spam via formulieren en nepaccounts.
- Voorraad-, prijs- of content scraping.
- Vertekende analytics en tragere responstijden voor echte bezoekers.
robots.txt is geen beveiligingsmuur
robots.txt vertelt coöperatieve crawlers welke delen zij niet horen te bezoeken. Een kwaadwillende bot kan het bestand negeren. Gebruik het daarom voor crawlsturing, niet voor geheimen of toegangscontrole. Gevoelige informatie moet met authenticatie en serverregels zijn beschermd.
Werk met meerdere beveiligingslagen
Begin met logging en patroonherkenning. Rate limiting remt clients die buitensporig veel verzoeken doen. Een web application firewall blokkeert bekende aanvalspatronen. Loginbeveiliging, MFA en CAPTCHA verminderen geautomatiseerd misbruik op risicopunten. Reputatie, gedrag, requestfrequentie en technische verificatie samen geven een beter oordeel dan één IP-blokkade.
Cachebare pagina’s kunnen door LiteSpeed-caching efficiënt worden geleverd, maar dynamische endpoints zoals login, zoeken, winkelmand en API’s verdienen afzonderlijke bescherming. Accountisolatie voorkomt bovendien dat één drukke of aangevallen site alle andere accounts meesleept.
En AI-crawlers?
Organisaties kunnen bewust kiezen welke AI-crawlers welkom zijn. Leg vast of vindbaarheid, bronvermelding, licentievoorwaarden of serverbelasting belangrijker zijn. Houd er rekening mee dat een regel in robots.txt alleen door meewerkende partijen wordt gevolgd. Meet eerst het werkelijke verkeer voordat u brede blokkades instelt.
Praktisch actieplan
- Meet welke URL’s, agents en netwerken de belasting veroorzaken.
- Verifieer legitieme zoekmachinebots volgens hun officiële methode.
- Bescherm login, formulieren, XML-RPC en API’s gericht.
- Stel rate limits per type endpoint in.
- Blokkeer aantoonbaar schadelijke patronen en controleer false positives.
- Monitor prestaties, conversies en crawlbaarheid na elke wijziging.
Veelgestelde vragen
Moet ik alle onbekende bots blokkeren?
Nee. Dat kan monitoring, zoekmachines, betaalproviders of andere integraties raken. Beperk eerst verdacht gedrag.
Helpt CAPTCHA tegen iedere bot?
Nee. CAPTCHA is vooral geschikt op formulieren en loginprocessen en hoort onderdeel van een bredere aanpak te zijn.
Kunnen bots mijn SEO schaden?
Indirect wel, bijvoorbeeld door uitval, trage pagina’s, gestolen content of enorme aantallen ongewenste URL’s. Goede crawlsturing en stabiele hosting beperken dat risico.
Vermoedt u ongewenst botverkeer? Open een ticket in het supportportaal en vermeld het tijdstip en de getroffen URL’s.